记忆层爆火之后:
压缩会丢掉「理由」
一句话结论:压缩省下的是上下文长度,丢掉的常常是推导过程。摘要里留一句「选了 B」很容易,留「为什么没选 A 和 C」很难——而后者才决定下次能不能安全地接着做。
一、这一类工具在做同一件事
最近记忆层工具很热,做法大同小异:捕获会话里的工具调用与关键事件,压成一份结构化摘要,下次开启会话时再注入回去;检索上多半是关键词索引加向量召回的混合,配上分层披露,先给概要、需要时再展开。
这套思路确实解决了一个真问题:对话一长,原始记录塞不进上下文,而模型又需要知道「之前发生过什么」。压缩是把历史从「全文」降成「要点」,用有限的位置换连续性。
官网已经写过五层记忆的分层与检索式召回和记忆机制,这篇不重复原理,只谈一个更少被讨论的代价。
二、有损的不是信息量,是可解释性
压缩必然有损,这一点大家都知道。但「损」具体损在哪,值得拆细一点。
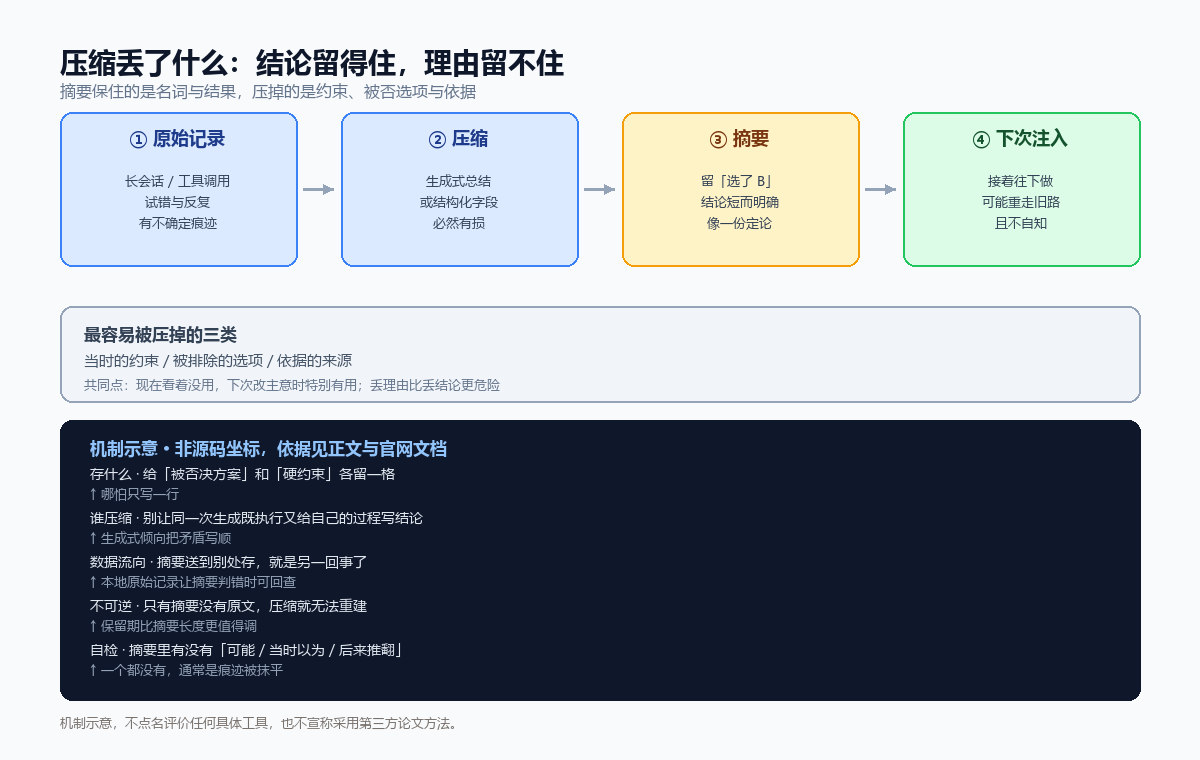
一份摘要最容易保住的是结论:最终选了哪个方案、文件改在哪、任务做完了没有。这些是名词和结果,短、明确、好概括。
最容易被压掉的是三类东西:
- 当时的约束:为什么不能用那个库、那台机器不能重启、这个字段不能改;
- 被排除的选项:试过 A,因为某个具体现象放弃了;C 看起来更快,但和数据归属冲突;
- 依据的来源:这个判断来自一次实测、还是来自当时的猜测、还是来自别人一句话。
它们共同的特点是「现在看着没用,下次改主意时特别有用」。丢掉结论,下次会重做一遍;丢掉理由,下次会信心十足地把已经否掉的路再走一遍,而且不知道自己走过。
更麻烦的是,摘要读起来往往比原始记录更干净、更像定论。压缩把不确定性和试错痕迹一起抹平了,模型拿到的是一份「事实清单」,而不是一份「当时的判断」。
三、三个取舍点
存什么。 如果只能留一份短摘要,至少给「被否决的方案」和「硬约束」各留一格,哪怕只写一行。比摘要长度更该被限制的,是摘要里能不能出现「因为」。
谁来做压缩。 由生成模型顺手总结,成本低,但它倾向于把材料写顺、把矛盾抹平;由结构化的字段去承接(哪类事件、哪个字段、哪个来源),可读性差一点,但不容易把「当时不确定」写成「已经确定」。这两种不是非此即彼,关键是别让同一次生成既负责执行又负责给自己的过程写结论。
数据留不留在本机。 这是压缩之外另一个独立问题。摘要再小,只要它被送到别处存,数据流向就变了。本地存储的价值不只是「更安全」,还包括一件很实际的事:原始记录还在本机,摘要判错时可以回查、可以重建。只有摘要、没有原文,压缩就是不可逆的。
Lyncore 这边的取舍是把索引和原始记录都留在本机、按字符做截断而不是按字节切,避免把一个汉字切开;分层解决的是「这一轮带哪些」,不是「把历史删成摘要」。这是机制描述,不是效果承诺。具体配置见记忆系统怎么配。
四、三个可以马上做的检查
- 拿一份旧摘要问一句「为什么没选另一条」:答不上来,说明只存了结论;
- 找一条被压缩掉的实测记录,看还能不能回查:回查不到,就把原文保留期调长;
- 看摘要里有没有「可能 / 当时以为 / 后来推翻」这类词:一个都没有,通常不是判断太准,是痕迹被抹平了。
记忆要解决的不是「记住多少」,是「下次能不能在原来的理解上继续」。结论让人知道做过什么,理由让人知道为什么那样做——后者更容易在压缩里悄悄消失。
延伸阅读:《五层记忆 vs 查询式召回》 讲分层;《上下文预算》 讲常驻说明的成本;配置见记忆系统怎么配。
文中行业动态来自公开报道,只作形态对照,未独立复现、不点名评价任何具体工具;文中「我们」的做法为机制描述,不构成效果承诺,也不宣称采用任何第三方论文方法。