「一切皆插件」之后:
装得越多,Agent 越笨吗
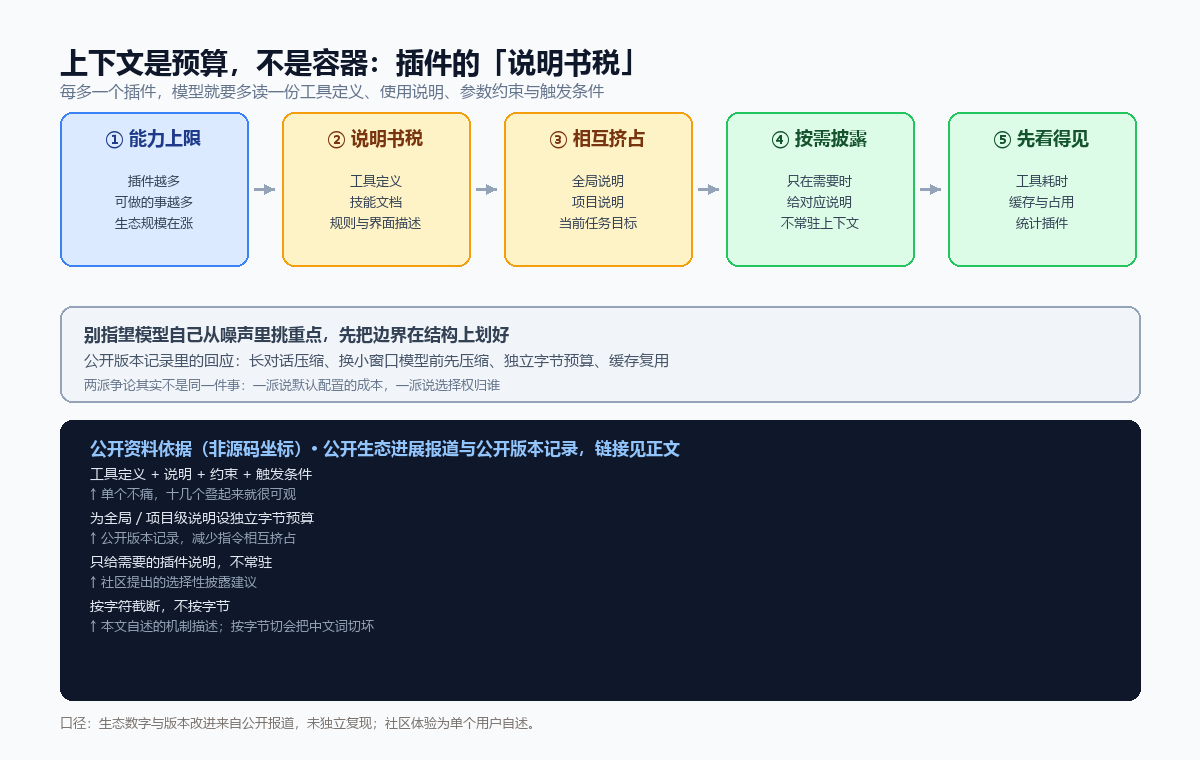
一句话结论:插件增加的是「能力上限」,同时在扣「上下文预算」。当工具说明、技能描述和规则常驻在提示里,模型得先花注意力读懂工具,才轮到推理任务本身——这两笔账必须一起算。
一、一个反直觉的社区反馈
11 月初,一边是生态数字在涨:公开进展里,第三方插件数量到了约 3.5 万个,约 60% 的活跃用户制作或安装过至少一款插件;另一边,社区开始出现相反的体验。
一位开发者写了自己从「什么都装」到主动删减的过程:装了 15 个以上插件之后,系统反而出现无限循环、上下文溢出、调用量上升。他的解释是,每增加一个插件,模型就要额外理解相应的说明、使用规则和约束;大量插件信息同时进入上下文,模型不得不把注意力花在工具本身,而不是任务推理上。他还提了一个更尖的问题:预设工具和规则太多,会不会反而限制模型自主解题的空间。
也有用户不买账:想省调用量就别装那些「活跃气氛」的插件,精简是使用者自己该负的责任,不该怪平台给了毛坯房而不是精装房。还有人建议借鉴选择性披露——只在需要时把对应插件的说明交给模型,而不是让所有说明始终占着位置。
两派都有道理,而且吵的其实不是同一件事:一派在说默认配置的成本,一派在说选择权归谁。
二、「说明书税」是怎么产生的
把上下文想成一个容器,容易得出「够不够装」的结论;把它想成一份预算,才会去问「谁该占、占多少、什么时候释放」。
一个插件进到运行环境,带来的往往不止一段可调用代码:
工具定义 + 使用说明 + 参数约束 + 触发条件 + 技能文档 + 界面描述这些大多要进模型上下文。单个插件不痛,十几个叠起来就很可观。更麻烦的是它们彼此挤占:全局说明、项目说明、人格设定、长期记忆、当前任务,本来就都在争同一块窗口。哪一类膨胀了,被挤出去的通常是最不该丢的那部分——当前任务的目标和验收条件。
所以问题不是「插件好不好」,是「插件说明有没有预算上限、能不能按需加载」。这也解释了为什么同样的工具数量,有的配置越用越顺,有的越用越绕:差在披露策略,不在数量。
三、官方已经在回应,而且方向很明确
翻公开的版本记录,能看到近一个月的更新重心明显从「怎么扩展」转向「怎么管住扩展」:
- 极简模式支持长对话自动压缩,并提供手动压缩指令;
- 切到上下文容量较小的模型时,先用原模型压缩历史再继续,避免一换模型就把前文挤爆;
- 为全局和项目级说明文件设独立字节预算,减少指令之间的相互挤占;
- 优化连续工具调用之间的历史上下文缓存复用;
- 加入实验性的开发者统计插件,能看上下文、缓存、模型和工具耗时;
- 插件侧则补齐了版本兼容性检查、依赖同步、启停与热重载,以及安装失败诊断。
最后两条最值得留意:先让成本可见,再谈优化。看不见工具耗时和上下文占用,任何「省了多少」都只是感觉。这一步比直接上压缩更工程。
四、我们这边的切法:把预算写进结构
同样的命题,另一种解法是从一开始就不让所有信息平铺在一层里。我们做记忆与上下文时守的是三条:
- 分层,而不是一个大筐:会话上下文、偏好、历史、行为模式、长任务状态各管一边,各自有生命周期和可见范围。哪一类涨了,不会直接糊到别的层上。
- 预算是硬约束,不是建议值:超了就截断,而且按字符截,不按字节——中文一个字三字节,按字节切会把词切坏,这类「悄悄损坏」最难查。
- 剔除当前会话再检索:找历史时把当前这轮剔掉,否则检索结果永远被自己刚说过的话占满,看起来命中率很高,其实没有新增信息。
这三条和插件生态的选择性披露是同一个思路的两种落点:别指望模型自己从一堆噪声里挑重点,先把边界在结构上划好。
五、三个可以马上做的检查
不用改架构,也能先看清自己那份预算花在哪:
- 数一数常驻说明有多少:把每次请求都会带上的工具定义、技能、规则列出来,看它们占了多少,其中有多少这次任务根本用不上。
- 看工具耗时分布,而不只看总量:总调用量涨了,可能是任务变复杂,也可能是工具说明太绕导致来回确认。
- 做一次「减配」对照:把插件砍到只剩必要几个,同一任务再跑一遍,比较结论质量和消耗。差异不显著,说明多装的那批只在收税。
插件越多越强,这句话要加个前提:在预算之内,并且按需出现。超出预算之后,多出来的不是能力,是噪声。
延伸阅读:《五层记忆 vs 查询式召回》 讲分层与检索式召回的取舍;《记忆系统怎么配》 讲配置;同系列 《AI 自己给自己造插件:造出来的东西谁验收》 讨论生成式扩展的另一半成本。
文中生态数字与版本改进来自公开报道与公开版本记录,未独立复现;社区体验为单个用户自述。文中「我们」的做法为机制描述,不构成效果承诺,也不宣称采用任何第三方论文方法。