AI 自己给自己造插件:
造出来的东西谁验收
一句话结论:让 AI 现场写出并装好一个插件,最难的从来不是「生成」,是「判定生成的这个东西能用」——尤其当写插件的和装插件的是同一个 Agent 时,验收权不能也交给它自己。
一、跑通一次,不等于一次生成就可用
11 月初,一种新玩法开始被集中讨论:在对话里描述一个需求,Agent 当场写出插件代码、装进自己正在运行的环境、再跑命令确认它生效。官方演示里,一个悬浮番茄钟从动手到验证走完约五分半钟;随视频发布的提示词合集列了七类场景,从 3D 地标展示、可视化演示,到海报工作台、论文阅读器、会话用量统计。
看着很顺。但真正值得停下来的,是官方在那份提示词合集开头写下的一句话:部分演示经过多轮对话反复打磨,单次生成的提示词不一定能完全复刻视频里的效果;同一批材料也明确提到,复杂插件能否稳定生成,目前还没有独立评测。
这两句是整套演示里最诚实的部分。它把「一次跑通」和「稳定可复现」这两件常常被混为一谈的事分开了。前者是演示,后者才是产品能力。把演示当能力写进结论,是这类内容最常见的失真。
二、六步里藏着一个「改了一处」
顺着公开的演示步骤看,流程大致是六段:加载插件开发说明 → 查询运行时有哪些可挂载位置 → 写代码 → 调用插件管理器把自己装进去 → 改一处 → 跑命令确认插件在运行。
第五步特别有意思:install_bundle 之后,Agent 又改了几行才通过验证。也就是说,即便在这条被剪辑过、被计时过的官方演示里,「生成 → 安装」也不是终态,中间还有一次修正。
这不是瑕疵,反而是最真实的一帧——它说明验证环节确实在起作用。反过来看,如果一套流程里根本没有「跑命令确认插件在运行」这一步,那么「装好了」这个说法就只剩文件系统上的痕迹,不构成可用。我们内部把这类区别说得很直白:配置写进去了 ≠ 生效了,得跑一次能把它打红的检查才算数。
三、验收要写进请求里,而不是事后补
生成式扩展有个很具体的麻烦:如果需求只写了「做个番茄钟」,那么 Agent 无论交出什么,都能自圆其说。它没有可对照的标准,只能自己给自己盖章。
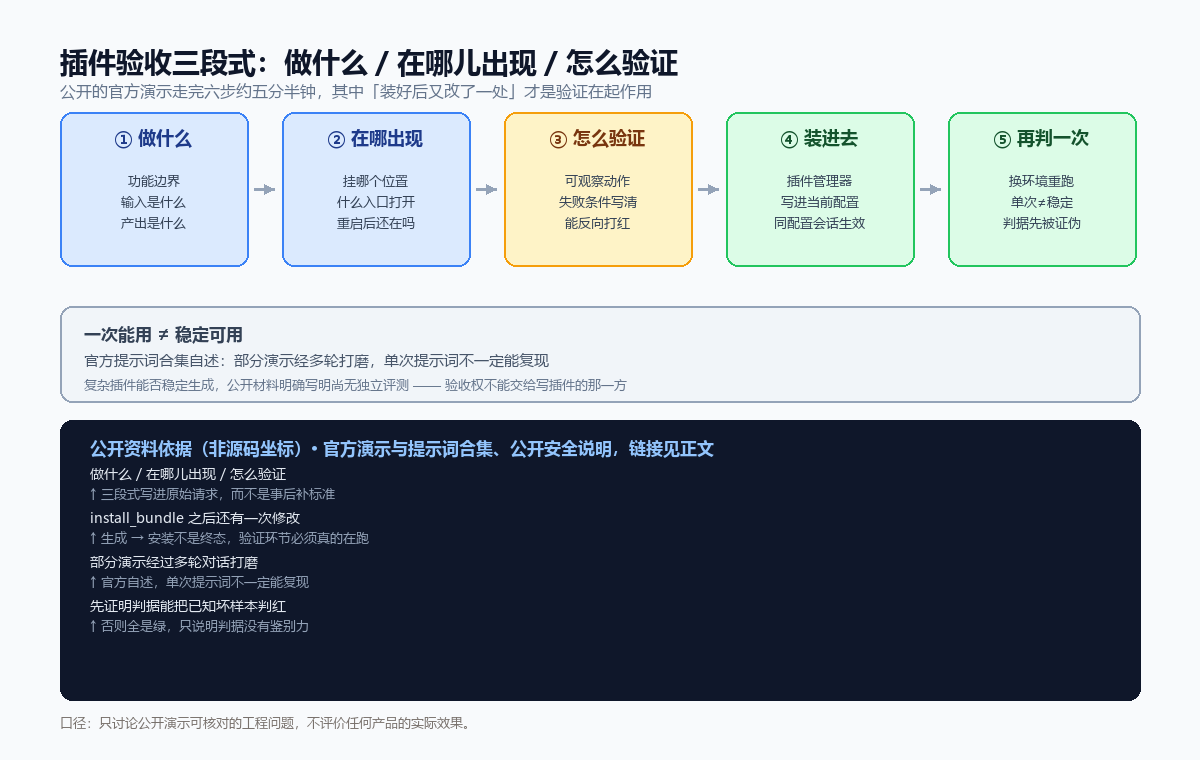
能落地的写法是把验收三段式写进原始请求:
| 段 | 要回答什么 | 写不清会怎样 |
|---|---|---|
| 做什么 | 功能边界、输入是什么、产出是什么 | 生成一个「看起来像」的界面就算交差 |
| 在哪儿出现 | 挂在哪个位置、以什么入口打开、重启后还在不在 | 做出来了,但找不到、或者下次启动就没了 |
| 怎么验证 | 用什么动作能证明它在跑,什么情况算失败 | 只能靠 Agent 自己说「已完成」 |
第三行是关键。验证动作必须是可观察、可重复的,最好还能反向做一次:把条件撤掉,检查应当失败。只做正向「我做完了」的声明,和没做验证差别不大。
四、我们踩过的同型坑:四种「假绿」
这类问题不新鲜,只是换了载体。做验收时最容易骗过自己的四种情形,放在生成插件这件事上逐一还能对上:
- 打桩:验证时把真正要调用的能力换成永远返回成功的替身。插件「安装成功」了,但被验证的是替身。
- 锚不可达:写了一条断言,可它指向的路径根本走不到,于是永远不触发,永远绿。
- 替身和实物不一致:验证环境里工具说明、界面位置、配置项和真实运行环境不是一套,演示通过、上线失败。
- 样本没有鉴别力:挑的例子太简单,换任何实现都能过;看起来 k 次全绿,其实一次都没区分出好坏。
四条有个共同点:它们都不是「代码错了」,而是「判据写错了」。所以顺序应该是先证明这套检查能把一个已知坏样本判红,再拿它去判新生成的插件。判据自己没被证伪过,它给的绿就不值钱。
五、三条能直接用的检查
不用引入新概念,下次让 Agent 给自己造东西时,可以先加这三条:
- 把失败条件写进请求:明确写「什么情况算没做成」,而不只写「做成什么样」。
- 要求一次反向验证:让它在装好之后执行一次能暴露问题的动作,并如实回报结果,不许用「已完成」代替。
- 换一次环境再看:重启、换一份配置、或在干净环境里重复同一条提示词,看结论是否还成立。演示视频里「装好就留在侧栏」是同一个配置内的持久化,跨配置是否成立是另一个问题。
生成能力越强,验收越要往前置。因为当写、装、验都由同一个执行体完成时,唯一还能站在外面说话的,就是那句事先写清楚、事后不能改的判据。
延伸阅读:《把验收契约写进流程》 讲判据怎么落进工程;《AI 工作流怎么配》 讲配置与生效的区别;本系列另有 《「不是沙箱」四个字,写在官方文档里》 讲插件的权限边界。早前对开源 Agent 原型的架构拆解见 《DeepSeek 开源 super-agent 架构精读》。
本文只讨论公开演示与官方文档中可核对的工程问题,不评价任何产品的实际效果;文中「我们」的做法均为机制描述,不构成效果承诺。