一个恒真的过滤条件:
为什么知识库总能把不相关的东西检索出来
一句话结论:检索最大的坑不是「没检索到」,是「什么都检索到了」。当过滤条件在结构上永远成立时,你的知识库对任何问题都有答案。
一、现象:问什么都能答,而且答得很像
知识库里只放了一份文档。用完全无关的问题去问,它照样给出答案,还引用了那份文档。
第一反应是提示词写得太软,让模型「尽量基于资料回答」。把提示词收紧之后,情况好了一点,但仍然会在没有依据时凑出内容。
于是去看检索层——问题果然在那里。
二、根因:一个永远不会失败的条件
混合检索的打分是两路加权:
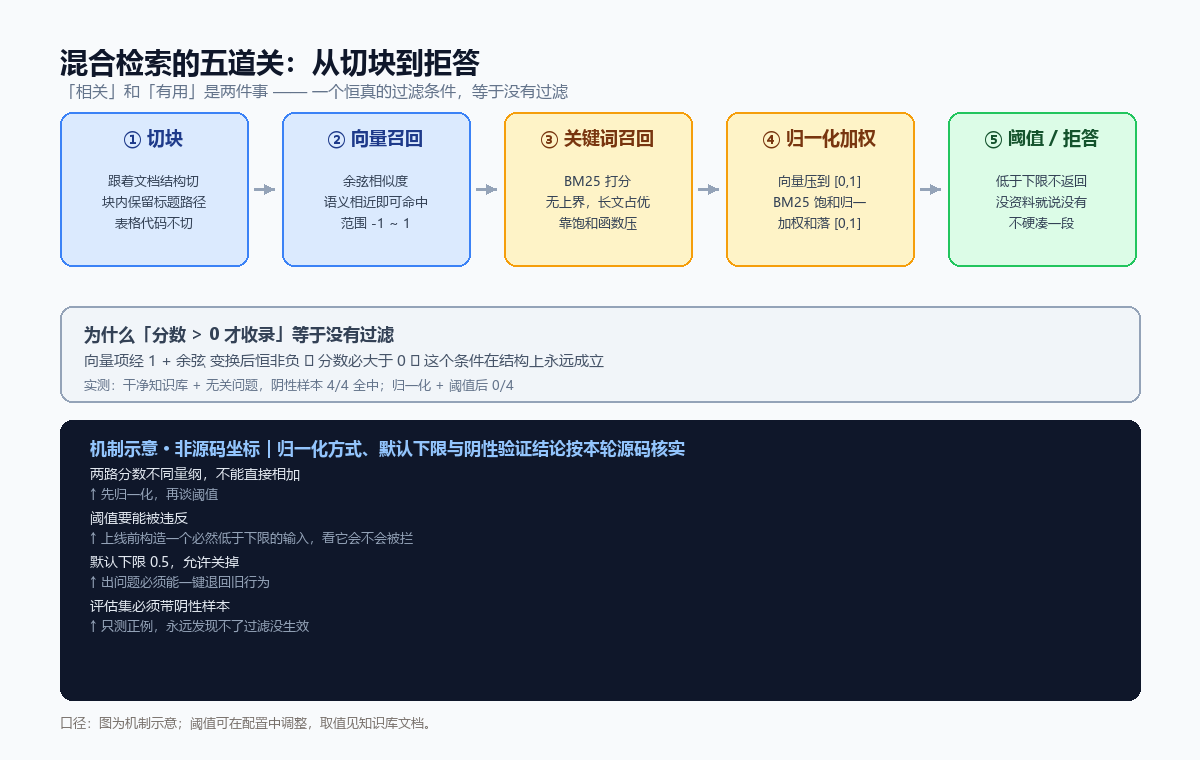
分数 = 向量权重 × 向量项 + 关键词权重 × 关键词项关键词那路是 BM25,永远 ≥ 0;向量那路用的是余弦相似度,经过 1 + 余弦 的变换之后,取值范围变成 [0, 2]——恒非负。
而过滤写的是「分数 > 0 才收录」。
把这两件事放在一起:只要余弦不等于 -1(现实中几乎不可能),分数就必然大于 0,这个条件在结构上永远成立。也就是说,过滤代码一直在执行,但从来没有过滤过任何东西。
这就是为什么「问什么都能答」:不是模型不听话,是检索层把一个不相干的分块一直当成候选喂了上去。
三、修法:先归一化,再谈阈值
真正要改的不是把阈值从 0 调到 0.6,而是让两路分数先站在同一把尺子上:
- 向量项归一化到 [0,1]:把
[0,2]的余弦映射过去,让「不相关」真的接近 0; - BM25 用饱和函数归一:BM25 没有上界,长文档天然占优;用
x/(x+k)这类饱和函数压到[0,1),避免关键词命中一次就把分数顶穿; - 加权和落回 [0,1],再与一个可配置的下限比较,低于下限的分块直接不返回。
下限默认取 0.5,并且允许关掉(取 0 即回退旧行为,只用于诊断对照)。保留一个「能关掉」的开关很重要:改检索这种事,出问题时必须能一键退回原状,否则没法定位是检索变差了还是模型变差了。
四、比修 bug 更重要的:评估集里必须有阴性样本
这个 bug 能活下来的原因很简单——测试只测了正例。
「问文档里的问题,能不能检索到」是全绿的;「问文档外的问题,会不会乱检索」根本没人测。而后者才是 RAG 在真实使用中的主要体验:用户问的十有八九不在你的资料里。
改完之后的验证方式是加阴性样本:拿四个与知识库主题完全无关的问题去问,要求一条都不命中。修复前是 4/4 全中,修复后是 0/4。
后面一个问题同样要治:没有答案时敢说没有。检索层过滤掉低分块之后,上下文里就没有资料了,这时正确行为是明确告诉用户「资料里没有相关内容」,而不是让模型自由发挥。
五、切块粒度也在同一件事上
另一个常见误区是按固定字数切块。文档是有结构的:一个章节里的定义、参数、示例被打断到两个块里,两块的向量都不完整,召回自然差。
更稳的做法是跟着结构走:按标题层级切,块内保留标题路径;表格和代码块不切开;每块带上来源文档与位置,用于回答时给引用。
六、可以直接照抄的四条
- 打分要可被违反:任何「阈值过滤」上线前,先构造一个必然低于阈值的输入,看它会不会被拦下来;
- 混合检索先归一化再加权,别把两个不同量纲的分数直接相加;
- 评估集必须有阴性样本,比例上不少于正例的三分之一;
- 检索改善与「拒答」要一起做——只会捞、不会说没有的系统,越用越不可信。
具体到落地,检索链路、切块规则和引用展示在知识库使用说明里有完整描述。
结论
RAG 的工程质量,八成不在模型,在检索层的这几个判断:分数是什么量纲、过滤条件能不能被违反、没有依据时敢不敢说没有。
一个恒真的条件比没有条件更危险——因为它看起来在工作。