数据不出本机这笔账:
本地数据库与云端推理,各管哪一段
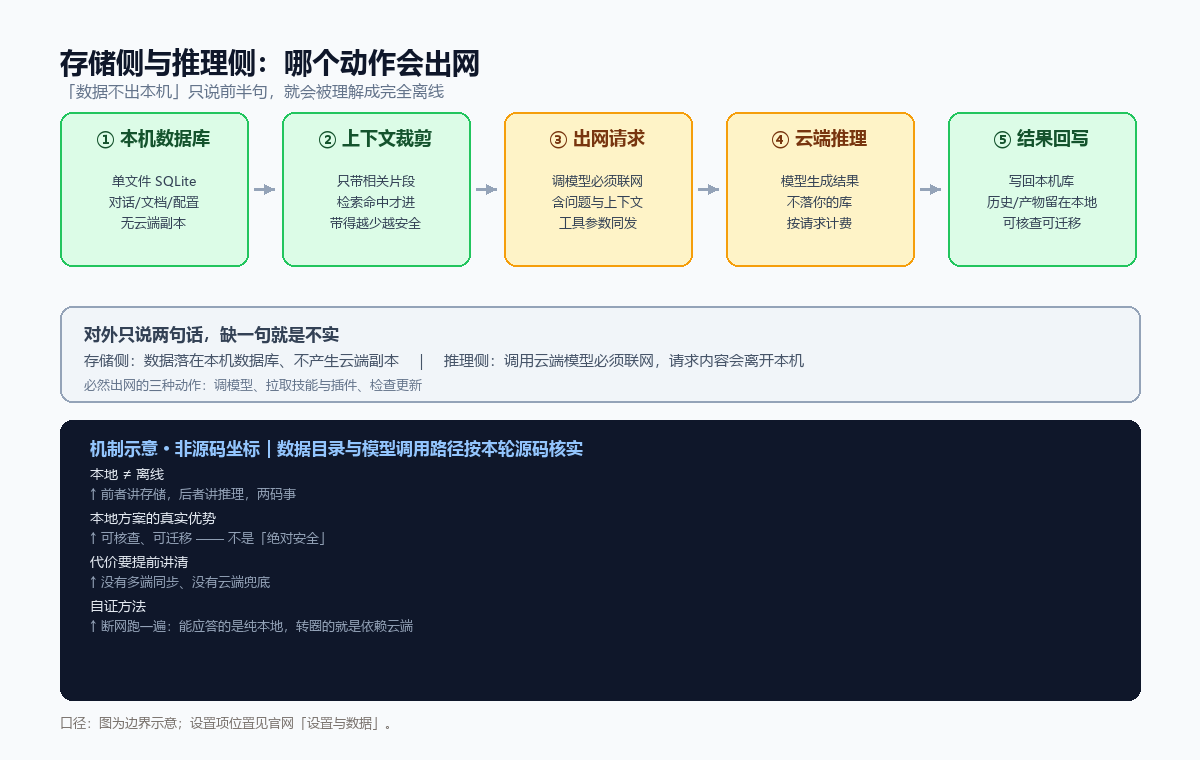
一句话结论:本地优先 AI 的隐私要分两步说——存储侧不出本机,推理侧必须联网。只讲前半句,等于把「本地存储」说成了「完全离线」。
一、为什么必须拆成两步
「数据不出本机」是一句正确但容易被误读的话。
用户听到它,通常理解成:我用这个工具干的任何事,外面都不知道。而真实情况是,数据分两类:
- 存储侧:对话记录、文档、配置、角色设定、任务历史——这些确实落在本机的一个数据库文件里,不产生云端副本;
- 推理侧:你要它干活,它得把问题发给模型。主流模型服务都在云端,这一步必然联网,请求内容会离开本机。
两件事都成立,缺一句就是不实。所以对外说法固定成两句:数据存在本机,推理需要联网。
二、存储侧:单文件的好处与代价
本地数据库最实在的好处不是「安全」,是可迁移:
- 备份 = 复制一个文件;
- 换机器 = 把这个文件搬过去;
- 想核对「它到底记了什么」= 直接打开看,不用申请导出。
代价同样明确,而且必须提前讲:
- 没有多端同步。手机和电脑不会自动一致,要一致就得手动搬文件;
- 没有云端兜底。硬盘坏了就是坏了,所以定期复制一份到别处这件事,得自己做;
- 多用户共用一台机器时要分账号。同一个文件被两个账号同时写会互相盖,正规做法是按账号分目录、各自一个文件。
这三点都不是缺陷,是这套架构的必然代价。诚实的做法是把它写在显眼处,而不是等用户踩到再解释。
三、推理侧:出去的是什么
一次任务里,真正发给云端的内容通常包括:
- 你的问题本身;
- 相关上下文——最近几轮对话、被选中要参考的文件片段、检索出来的知识块;
- 工具调用所需的参数(比如要执行的命令、要读的文件路径)。
不出去的通常是:完整数据库、未被引用的文件、你账号里的余额与订单这类账户数据(这些只在本地或自有服务里流转)。
所以真正可控的不是「出不出网」(推理必须出网),而是出去多少:上下文带得越少,暴露面越小。这也是为什么「只把相关的那一段检索进去」既是省成本的优化,也是隐私的优化。
四、三种动作必然出网
- 调模型:问答、写文档、分析表格,都会发请求;
- 拉取技能与插件:安装、更新扩展时要从远端取内容;
- 检查更新:启动时核对版本。
反过来,纯本地能做的:打开历史对话、查看文件、改配置、看任务列表、编辑记忆。这些断网也能用。
五、怎么自己验证
最直接的办法:断网跑一遍。
把网络断开,然后逐个动作试:能正常打开的,就是纯本地;转圈报错的,就是依赖云端。这比读任何说明都可靠,因为它是你自己测出来的。
第二个办法:看设置里数据目录的位置,确认数据库文件确实在你机器上,并且知道它多大、什么时候改过。知道文件在哪,才谈得上「数据在我手上」。
六、常见误读
- 「数据不出本机」≠「完全离线可用」。前者讲存储,后者讲推理,两码事;
- 「本机数据库」≠「加密保险箱」。文件在你自己机器上,物理安全靠系统账户与磁盘加密;
- 「不上传」≠「不外发」。你让它写一封邮件、发一条消息,内容当然会出去——这是你要它做的事,不是它偷偷做的事。
结论
- 讲隐私要讲两句,少一句就是不实;
- 本地方案的真实优势是可核查、可迁移,不是「绝对安全」;
- 真正能优化的是上下文体积:带得越少,出网的东西越少;
- 验证方式别靠承诺,靠断网跑一遍。
设置项与数据目录的具体位置,见设置与数据。