发往模型之前,
把密钥抹掉:三个档位的取舍
一句话结论:脱敏不是「全部变成星号」。全遮最安全,但也最没用——用户认不出那是哪一条,排查时也无从下手。
一、先承认一个前提
用云端模型,就意味着内容要出本机。这个事实不因为「加密传输」而改变——服务端能看到明文,否则它没法推理。
所以问题不是「要不要上传」,是上传的那一段里有没有本不该带出去的东西。
密码、令牌、私钥、身份证号、客户手机号——这些东西出现的位置往往不是正文,是粘贴进来的日志、配置片段、报错信息。人不会每次都记得先删掉它们。
结论很直接:这件事不能交给用户的自觉,只能做在出站的管道上。
二、三个档位,各治一种情况
把所有可疑内容都打成星号,是最省事的做法,也是最容易把人赶走的做法。因为脱敏之后的文本,用户自己要读、要核对、要在下一次对话里引用。
所以档位是按「这段内容脱敏后还有没有用」来分的。
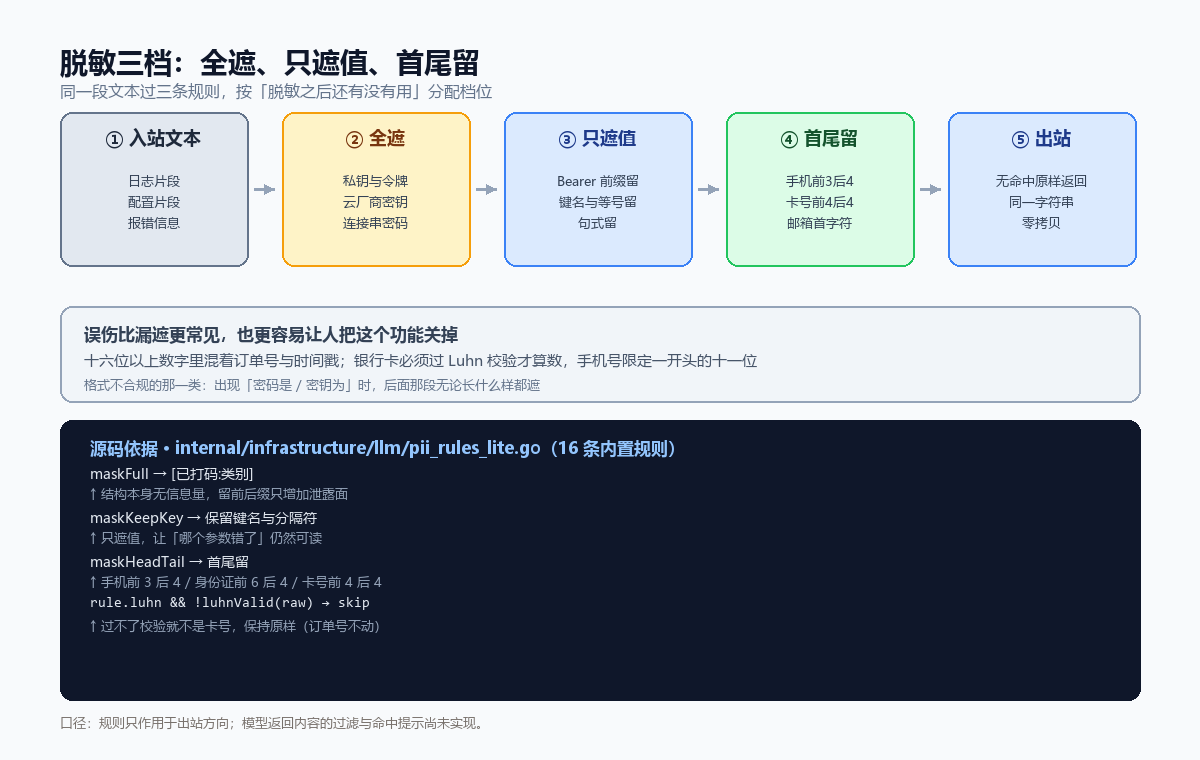
第一档:全遮。 私钥块、JWT、各家云厂商的访问密钥、连接串里的密码段——这些内容的结构本身没有信息量,留着前后缀只会增加泄露面。整段替换成带类别标签的掩码,例如「已打码:密钥」。
第二档:保留结构、只遮值。 Authorization: Bearer xxx 保留「Bearer」这个词,只遮值;password=xxx 保留键名与等号,只遮值;「密码是 xxx」保留句式,只遮后面那一段。
这一档的价值在于可读性。一个配置片段被遮完之后,用户还能看出「是哪个参数出的问题」,只是看不到具体值。全遮的话,整行变成掩码,什么都判断不了。
第三档:首尾留。 手机号留前三后四,身份证留前六后四,银行卡留前四后四,邮箱留首字母和域名,内网地址留前三位。
这一档解决的是「认得出来吗」。用户说「我那次登录的手机号」,如果界面上是一串星号,他没法确认是不是自己那条。留头留尾之后,本人一眼能认出,旁观者仍然拼不出完整号码。
三、真正的敌人是误伤,不是漏遮
写过规则的人都知道,漏遮很危险,但误伤更常见,而且更容易让人放弃这个功能。
最典型的是银行卡规则:十六到十九位连续数字。而订单号、流水号、时间戳、长整型 ID 全都长这样。如果只按长度匹配,一次对话下来能把日志里的订单号全打成星号——用户会以为工具坏了。
这里有个现成的工具:Luhn 校验。银行卡号满足这个校验和,订单号基本不满足。规则加上这一道,误伤能压到很低。
同样的思路用在其他地方:
- 手机号必须是 1 开头的十一位,且第二位在 3 到 9 之间;
- 身份证必须是十八位,末位允许 X;
- 日期、金额、普通网址、短数字一律不动;
- 邮箱只认带域名后缀的形态,不把
@用户名这种写法当邮箱。
这些细节听起来琐碎,但它们决定了这个功能是「一直在帮忙」还是「一直在添乱」。误伤率高的脱敏,用户第一件事就是把它关掉。
四、还有一类:格式不合规的密码
前面三档都在匹配「长得像什么」。但现实里最常见的一句是:
密码是 admin123
admin123 不符合任何密钥格式——没有前缀、没有长度、没有特征。任何基于形态的规则都抓不到它。
所以还需要一类上下文触发:当文本里出现「密码 / 口令 / 密钥」这类词,后面跟「是 / 为 / 冒号」,那么后面那一段无论什么形态都遮掉。
这一类的判据不是「它长什么样」,是「它出现在什么位置」。宁可多遮一句,也不能漏掉一句真正的密码。
五、做在出站那一层
位置比规则重要。
如果把脱敏做在输入框里,用户看到自己打的字被改,会先愣一下;如果把脱敏做在提示词拼装之前,那么所有走模型调用的路径都得各自记得调用一次——新增一条路径就会漏。
我们的做法是放在出站管道的最后一层:所有要发出去的内容都从这里过,先过一份自定义词条名单,再过内置规则。没有命中就原样返回同一个字符串,连一次内存拷贝都不做——正常对话里,这条管道应该是零成本的。
配置相关的说明见设置。
结论
- 脱敏不是一种处理,是三种:全遮、只遮值、首尾留,按「脱敏后还有没有用」分配;
- 全遮的代价是可读性,只遮值的收益是可排查,首尾留的收益是可辨认;
- 误伤比漏遮更容易让人关掉功能。长度匹配必须配校验(银行卡走 Luhn),区间匹配必须收窄(手机号限定号段);
- 基于形态的规则抓不到「密码是 admin123」。必须有一类规则按上下文位置判,而不是按长相判;
- 位置只能有一个:出站管道的最后一层。分散到各个调用点,等于给未来留一个漏口。
还没解决的
这套规则只覆盖了一个方向:发出去的内容。模型返回的内容里同样可能带敏感信息(比如它复述了上下文里的某个号码),返回方向的过滤还没做,而它要动流式管道,代价比出站大得多。
另一个缺口是反馈:用户不知道自己这次被遮了几处。命中统计已经在管道里算出来了,但没有回传到界面上——用户只能凭感觉相信它工作了。