先决定、后动手:
用事务外发队列让 Agent 重启不丢活
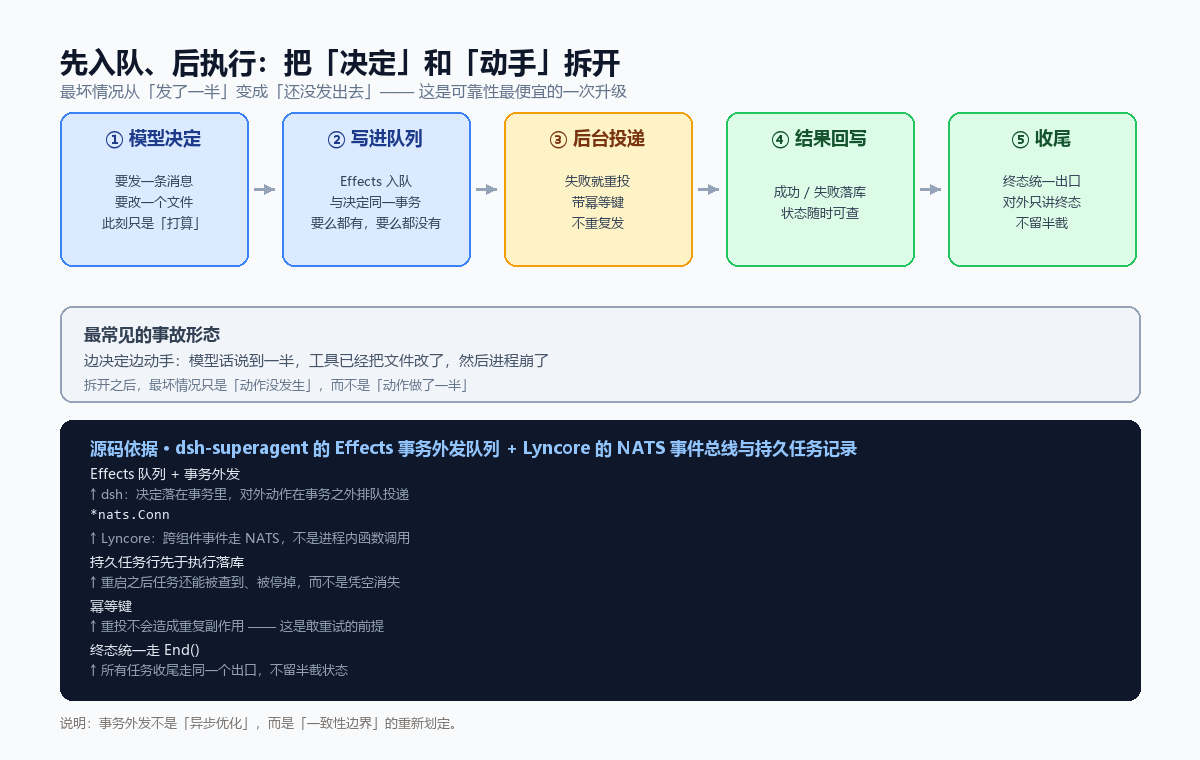
一句话结论:Agent 系统最隐蔽的bug,不在模型,而在"决定做了"和"真的做了"之间的缝隙——决定要发一条回复,进程这时候崩了,回复就永远没出。把副作用从"调用时立刻执行"改成"先落库、后执行、失败重试",是让 Agent 重启不丢活的关键一刀。DeepSeek 的 dsh-superagent 用 Effects 事务外发队列实现,Lyncore 用 NATS 事件总线 + 持久任务记录做同一件事。
问题出在"边决定边动手"
看一段朴素(但脆弱)的写法:
decide()          // 模型判断:该回复用户了
send_reply()      // 立刻发消息
mark_done()       // 落库标记完成
如果在 send_reply() 之后、mark_done() 之前进程挂了:消息发出去了,但库里还记着"没完成",重启后可能再发一次。反过来,如果 send_reply() 本身网络超时失败,但 mark_done() 已经写了,那就永远丢了这次回复,系统以为干完了。
根因:把"决策"和"副作用"放在同一条同步链路上,两者的失败域被绑死了。
dsh-superagent 的 Effects:先入队,后执行
dsh-superagent 的解法干净(见 docs/007-architecture.md):所有对外动作——发消息、启动执行、投递输入、转发给主会话——都先作为 Effects 存进数据库,提交事务之后才真正执行。
几个设计要点:
- 事务内 enqueue,提交后 execute。 决定和行动不再同步耦合;要么一起成,要么动作根本没排进队列。
- 同类合并 + 优先级 + 退避重试。 同 key 的 effect 合并;失败先等 2 秒,再翻倍到上限;连续失败三次才升级成系统问题。
- 崩溃可续。 重启时,未执行的 effect 还在库里,按顺序补发;已经发出的不重复。
它甚至把这条原则上升成一句话:"先存后做(stored first, done afterwards)"。这其实就是后端系统里经典的 事务外发队列 / transactional outbox 模式,只是用在了 Agent 的工作流上。
Lyncore:NATS 事件总线 + 持久任务记录
Lyncore 走的是同一思路,但落到了分布式的事件总线上:
- 核心用 NATS(
github.com/nats-io/nats.go,*nats.Conn)做事件总线,把"任务状态变化""执行进度""配额变动"等作为事件发布出去,而不是在调用链里同步推。 - 任务的每一次状态跃迁、每个 DAG 运行事件,都进持久化的任务记录(如
dag_run_events),重启或worker 掉线后能照着记录续上,不丢活。 - 终态统一走收口逻辑(
recordSyncTerminal),保证"结束"这件事也是落库优先、可追溯。
换句话说:dsh 用进程内单库的事务队列就够(它本就是单部署、单仓库场景);Lyncore 因为有多worker、可能多节点,把同一语义搬到了 NATS + 分库持久记录上,隔离度和规模更大,但"先决定、后动手"的内核完全一致。
对照阅读:《主会话 + 工作会话》 讲动作由谁执行;《把"等人"做成一等公民状态》 讲状态怎么可恢复。
这条原则带来三个实打实的好处
- 幂等有了锚点。 因为动作先入队、带 key,重试时天然能合并/去重,不会"发了又说没发"。
- 失败被隔离。 发消息失败了,不影响"决定已经做了"这件事的持久性;反过来,决定没落库,动作就根本不会排进队列。
- 重启可续,不丢活。 进程死了,队列和记录还在;起来后按序补发,人感知不到中断。
什么时候该上这套
单进程、单次、不怕重跑的脚本,确实没必要。但只要你的 Agent 会对外产生副作用(发消息、开 PR、调 API、改数据),并且可能中途挂掉或被重启,事务外发就是底线配置——否则"丢活"和"重复动手"会轮流出现,且极难复现。
本系列
- DeepSeek 开源 super-agent 架构精读:一条 @提到 怎么变成一次 PR
- 主会话 + 工作会话:Agent 编排里"大脑与手"为什么要分开
- 把"等人"做成一等公民状态:Agent 的人机协同怎么设计才不卡死
- 五层记忆 vs 查询式召回:Agent 到底该不该有长期记忆
- DeepSeek 给自主 Agent 定的三条铁律
本文以 DeepSeek 开源的 dsh-superagent(MIT)为例子。Lyncore 的事件总线与任务持久化设计见官网 lyncore.top 与技术文档。