把每天的重复活交出去之后,
我才开始担心它漏跑
一句话结论:定时任务的难点不在「按时启动」,在没启动的时候你怎么知道。
一、交出去的头两周
每天早上的固定动作:把三份表格汇总成一张总表,按区域拆出异常项,再写一段摘要发到群里。
手工做要二十分钟,做久了会烦——烦的不是难,是每天都一样。于是设成定时任务:每天早上八点半跑一次,跑完把结果放到固定目录。
头两周很爽。八点半之后我只要看一眼结果对不对,剩下的时间可以做别的。
第三周开始出问题,全是「自动化之后才会有」的问题。
二、坑一:机器关着,它当然不跑
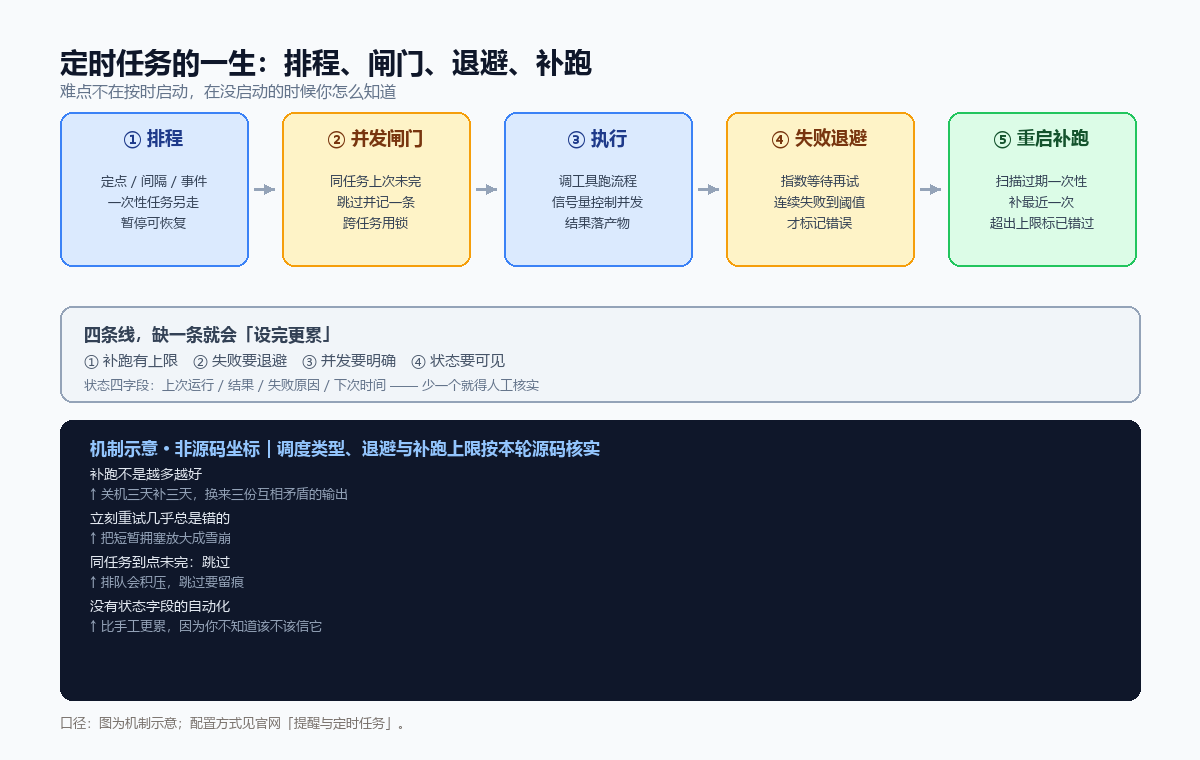
第一类问题最朴素:那天早上没开机,八点半什么也没发生。等我十点开机,它也没有补上——因为任务在执行那一刻才被触发,错过就错过了。
更麻烦的是「一次性任务」。设了个明天上午十点的提醒,结果那天上午在开会,电脑没开,晚上打开时这条任务已经过期,界面上还挂着「待执行」。
这类问题的正解是启动时做一次过期检查:开机时把已经过期的任务挑出来,问一次「要不要补跑」。但这里立刻会遇到第二个问题——如果关机三天,是不是要把三天的都补一遍?
所以要有一条上限:补跑有次数限制,超过就只补最近的一次,其余标记为「已错过」。用「把三天的活一口气补完」换来的,往往是三份重复的、互相矛盾的输出。
三、坑二:失败之后立刻重试,等于自己打自己
第二类问题是失败处理。
第一版的做法很直觉:失败了就重试。结果第一次撞上一个上游接口的临时故障,它一秒内重试了五次,全失败,然后任务状态变成错误——而实际上第六次可能就成功了。
正确的做法是指数退避:第一次失败等几秒,第二次等更久,连续失败超过若干次才真正标记错误。中间那几次只记日志,不算彻底失败。
这条经验不只适用于定时任务:凡是调用外部服务的地方,立刻重试几乎总是错的——它把一个短暂的拥塞放大成了雪崩。
四、坑三:两个任务撞在一起
第三类问题最隐蔽:两个任务同时读写同一份数据。
我设了两个任务,一个上午整理总表,一个中午发摘要。有一次上午那步慢了,跑到中午还没结束,于是中午那个任务拿着半张表生成了摘要——数字对不上,但流程「成功」了。
两个层面都要治:
- 同一个任务的并发:
overlap策略要明确——到点时上一次还没跑完,是排队等、还是跳过这次。多数场景应该跳过,并明确记一条「因上次未完成而跳过」,否则你会看到一串排队积压。 - 不同任务之间的冲突:靠信号量或资源锁。同一份数据只允许一个任务持有写权限,拿不到就等或者退。
五、最容易忽略的一件事:能不能一眼看出跑没跑
前三类坑修完之后,我发现真正省心的关键是可观测性,不是调度精度。
现在每个任务列表里必须能看到:上次运行时间、结果状态、如果是失败则失败原因、下次预计运行时间。有这四个字段,早上的动作从「打开文件夹看有没有新表」变成「扫一眼列表」。
没有这四个字段,自动化反而更累——因为你不知道它到底跑没跑,于是每次都要去核实。
六、给自动化上四条线
- 补跑有上限:关机多天只补最近一次,其余标「已错过」;
- 失败要退避:指数等待,连续失败到阈值才算错;
- 并发要明确:同任务跳过或排队,跨任务用锁;
- 状态要可见:上次运行、结果、原因、下次时间,四个字段缺一不可。
定时任务的配置方式见提醒与定时任务。
结论
自动化不是「设完就不用管」,而是「把管理对象从执行换成监控」。
设任务只要五分钟,让它可靠要花的时间都在后面这三件事上:漏跑怎么发现、失败怎么退、撞车怎么让。